Architecture First: как небольшой командой с ИИ сделать альтернативу Jira — Часть 6.
Предыдущая статья закончилась первой версией бэкенда, которая работала только на локальной машине. Сейчас выкладываем её на настоящий сервер.
Задача простая: запустить бота на самой дешёвой инфраструктуре, которая с ним справится. Один небольшой VPS, Docker Compose, PostgreSQL на том же сервере с ограничением по памяти и GitHub Actions, который на каждый push в main собирает проект и отправляет результат на сервер.
Что получится в итоге:
- бот и база работают на одном VPS в двух контейнерах, которыми управляет Docker Compose;
- push в
mainзапускает сборку на .NET 10 и по SSH копирует файлы на сервер; - PostgreSQL настроен под 1 ГБ памяти и принимает подключения только с двух адресов;
- бот сам забирает обновления у Telegram через long polling, поэтому публичный HTTPS-адрес пока не нужен.
Сервер: один VPS на всё
Мы делаем не корпоративную систему и не хотим платить много, пока проект ничего не приносит. Поэтому никакого Kubernetes, управляемых контейнеров и облачной базы: всё живёт на одном небольшом VPS.
Сервер у нас уже был. На VPS с 1 ГБ RAM работает этот блог, а провайдер позволяет поднять память до 3 ГБ в пару кликов. Прикинули так: около 1 ГБ приложениям, около 1 ГБ PostgreSQL, остальное — системе, блогу и демо-проектам. Одного сервера за несколько долларов в месяц на всё это хватает.
PostgreSQL на своём сервере вместо managed-базы
У управляемой базы есть настоящие плюсы: автоматические бэкапы, failover, восстановление на любой момент времени. Но платить за них стоит тогда, когда есть что защищать. PostgreSQL на том же VPS почти ничего не стоит: сервер оплачен, нагрузки, с которой он не справится, пока нет, а бэкапы самого сервера дают минимальную гарантию, что данные не пропадут. Когда потеря данных станет дорогой, переезд на managed-базу будет разумным шагом.
По той же логике позже и медиафайлы будут лежать в файловой системе VPS, а не в S3-подобном хранилище.
GitHub Actions: сборка и выгрузка
Выгрузка на сервер происходит при каждом push в ветку main. Workflow лежит в .github/workflows/dotnet.yml:
name: .NET
on:
  push:
    branches: [ "main" ]
  pull_request:
    branches: [ "main" ]
jobs:
  build:
    runs-on: ubuntu-latest
    steps:
    - uses: actions/checkout@v4
    - name: Setup .NET
      uses: actions/setup-dotnet@v4
      with:
        dotnet-version: 10.x.x
    - name: Restore dependencies
      run: dotnet restore
    - name: Build
      run: dotnet build --no-restore -c Release
    - name: Upload Telegram Host
      if: github.ref == 'refs/heads/main'
      uses: marcodallasanta/[email protected]
      with:
       host: ${{ secrets.SSH_HOST }}
       port: ${{ secrets.SSH_PORT }}
       user: ${{ secrets.SSH_USER }}
       password: ${{ secrets.SSH_PASSWORD }}
       local: src/Laraue.Apps.Boards.TelegramHost/bin/Release/net10.0/*
       remote: "/home/laraue/boards-telegram-host"
       post_upload: echo "Uploaded successfully"
Сборка (restore и build) идёт и на push, и на pull request, так что сломанный проект видно ещё до слияния. Шаг выгрузки стоит под условием github.ref == 'refs/heads/main', поэтому файлы на сервер попадают только из main: workflow собирает проект на .NET 10 и по SSH копирует результат в /home/laraue/boards-telegram-host. Данные для подключения хранятся в GitHub secrets (Settings → Secrets and variables → Actions) и в репозиторий не попадают.
Dockerfile
Собранные файлы бота упаковываются в контейнер маленьким Dockerfile BoardsTelegramHostDockerfile, который лежит на сервере:
FROM mcr.microsoft.com/dotnet/aspnet:10.0
RUN apt-get update && apt-get install -y --no-install-recommends curl \
    && rm -rf /var/lib/apt/lists/*
COPY boards-telegram-host app
WORKDIR app
ENTRYPOINT ["dotnet", "Laraue.Apps.Boards.TelegramHost.dll"]
В образ копируется готовый результат сборки из CI. Для запуска хоста нужен только runtime, а не весь .NET SDK, поэтому образ получается небольшим.
Зачем в образе curl
Единственная неочевидная строка здесь — установка curl. Runtime-образы .NET минимальны: начиная с .NET 8 в них нет ни curl, ни wget. Приложению это не мешает, но healthcheck контейнера должен сделать HTTP-запрос к эндпоинту /_health работающего хоста, и без curl ему нечем его сделать.
Docker Compose: бот и база в одном файле
Compose объединяет два контейнера, бота и PostgreSQL, в один деплой:
version: '3.4'
networks:
  dockerapi-dev:
    driver: bridge
services:
  boardstelegramhost:
    build:
      context: .
      dockerfile: "BoardsTelegramHostDockerfile"
    expose:
      - "5006"
    ports:
      - "8086:5006"
    restart: always
    environment:
      ASPNETCORE_ENVIRONMENT: "Production"
      Kestrel__EndPoints__Http__Url: "http://+:5006"
      Telegram__Token: "TokenHere"
      ConnectionStrings__Postgre: "User ID=PostgresUser;Password=PostgresPass;Host=postgres;Port=5432;Database=laraue_messages_board;Command Timeout=0;"
      Logging__LogLevel__Default: "Warning"
    depends_on:
      postgres:
        condition: service_healthy
    networks:
      - dockerapi-dev
    deploy:
      resources:
        limits:
          memory: 256M
    healthcheck:
      test: ["CMD-SHELL", "curl -fsS http://localhost:5006/_health || exit 1"]
      interval: 5s
      timeout: 3s
      retries: 10
      start_period: 10s

  postgres:
    image: postgres:18-alpine
    container_name: postgres_db
    restart: always
    command: postgres -c config_file=/etc/postgresql/postgresql.conf
    environment:
      PGDATA: /var/lib/postgresql/data
      POSTGRES_USER: PostgresUser
      POSTGRES_PASSWORD: PostgresPass
    volumes:
      - /home/laraue/postgres_data:/var/lib/postgresql/data
      - ./postgres.conf:/etc/postgresql/postgresql.conf
      - ./pg_hba.conf:/etc/postgresql/pg_hba.conf
    networks:
      - dockerapi-dev
    expose:
      - "5432"
    ports:
      - "5432:5432"
    healthcheck:
      test: ["CMD-SHELL", "pg_isready -U PostgresUser -d laraue_messages_board"]
      interval: 10s
      timeout: 5s
      retries: 5
      start_period: 10s
    deploy:
      resources:
        limits:
          memory: 1024M
Несколько пояснений к этому файлу.
Лимит только на память. У каждого сервиса есть потолок по памяти, а лимита на CPU нет. На VPS всего одно ядро, и ручные ограничения по процессору там скорее вредят: сервисы стартуют заметно медленнее, база отвечает медленнее. Лимит памяти, наоборот, нужен: он не даёт одному контейнеру занять всё и оставить соседей без памяти. Поэтому память ограничена явно, а процессор делит планировщик ОС.
Healthcheck и зависимости. Бот проверяется запросом curl к эндпоинту /_health, который мы добавили в хост в прошлой статье. База проверяется командой pg_isready. Бот ждёт базу через depends_on с условием service_healthy, так что не начнёт стартовать, пока PostgreSQL не готов принимать подключения. Сам по себе healthcheck контейнер не перезапускает: он только помечает его как unhealthy, и это видно в docker ps. Перезапуск при падении процесса обеспечивает restart: always.
Данные PostgreSQL лежат на диске VPS. Каталог /home/laraue/postgres_data монтируется в /var/lib/postgresql/data внутри контейнера, куда Postgres пишет свои файлы. Поэтому данные переживают пересоздание контейнера и видны в обычной файловой системе сервера.
Секреты в примере ненастоящие. Реальные значения прописаны в таком же файле на сервере.
Настройка PostgreSQL под 1 ГБ памяти
Своя база означает, что настраивать её нужно самому. Конфигурация по умолчанию позволяет Postgres запуститься даже на очень слабом сервере, но на более мощном он не использует доступные ресурсы. Подобрать значения под конкретный сервер помогают онлайн-калькуляторы параметров Postgres. У нас получился такой postgresql.conf:
shared_buffers = 256MB
effective_cache_size = 768MB
work_mem = 16MB
maintenance_work_mem = 64MB
max_connections = 75
wal_buffers = 16MB
min_wal_size = 1GB
max_wal_size = 2GB
checkpoint_completion_target = 0.9
random_page_cost = 1.1
effective_io_concurrency = 200
listen_addresses = '*'
hba_file = '/etc/postgresql/pg_hba.conf'
Главные параметры — два. shared_buffers (256 МБ, около четверти выделенной базе памяти) — кеш страниц данных. effective_cache_size (768 МБ) — подсказка планировщику, сколько памяти в сумме доступно под кеш с учётом файлового кеша ОС. Параметр random_page_cost = 1.1 сообщает планировщику, что случайное чтение дёшево; для серверов с SSD это рекомендуемое значение. По сути это обычная подгонка Postgres под реально доступную память, то есть то, что managed-база делает за вас. Файл лежит рядом с docker-compose.yml и подключается к контейнеру строкой ./postgres.conf:/etc/postgresql/postgresql.conf.
Одного монтирования мало. Официальный образ запускает Postgres с конфигом из каталога данных и сам /etc/postgresql/ не читает, поэтому строка command в compose-файле выше указывает Postgres на наш файл. Остальное делают две последние строки конфига: listen_addresses = '*' позволяет боту подключаться к базе из другого контейнера (с собственным конфигом по умолчанию слушается только localhost), а hba_file заставляет Postgres взять наш pg_hba.conf вместо файла из каталога данных. Мы сначала просто примонтировали оба файла и не заметили, что они игнорируются. Проверить, что настройки применились, можно так:
docker exec postgres_db psql -U PostgresUser -c "show config_file; show hba_file; show shared_buffers;"Должны вернуться два файла из /etc/postgresql/ и 256MB. Если вы видите пути в /var/lib/postgresql/data и 128MB, значит, всё ещё действуют настройки по умолчанию.
Закрываем доступ к базе через pg_hba.conf
Открытую всему интернету базу держать не стоит. Доступ к Postgres ограничивается в pg_hba.conf: подключиться может один внешний IP, всё остальное отклоняется:
# TYPE  DATABASE  USER  ADDRESS         METHOD
local   all       all                   trust
host    all       all   127.0.0.1/32    md5
host    all       all   ServerIp/32     md5
host    all       all   172.16.0.0/12   md5
host    all       all   0.0.0.0/0       reject
Локальным подключениям, адресу VPN и сетям Docker мы доверяем (172.16.0.0/12 — диапазон, из которого Docker выдаёт адреса bridge-сетям; бот подключается именно оттуда), остальные отклоняются. Порт базы опубликован на хосте, поэтому именно этот файл не пускает к ней интернет. Postgres просматривает правила сверху вниз и останавливается на первом подходящем, так что последняя строка с reject нужна скорее для наглядности.
ServerIp — это адрес self-hosted VPN, который поднят на том же сервере. С локальной машины мы подключаемся к нему через Amnezia (протокол AmneziaWG), и пока VPN включён, для Postgres локальный компьютер выглядит доверенным адресом. Поэтому к базе можно подключиться напрямую из такого инструмента, как DataGrip.
Связь с Telegram: long polling
Бот общается с Telegram через long polling: он сам запрашивает обновления, а не ждёт их на публичном вебхуке. Для деплоя это удобно, потому что публичный HTTPS-адрес для сервера пока не нужен.
Что лежит на сервере
Всё, что относится к нашим проектам, находится на VPS в каталоге /home/laraue/:
- папки с выгруженными сборками, например
boards-telegram-host, куда CI кладёт бота (рядом позже появитсяboards-webapi-hostдля web API из следующих статей); - Dockerfile каждого приложения;
- конфиги
postgres.confиpg_hba.conf; docker-compose.ymlсо всеми сервисами;- каталоги с данными для bind mount, пока только
postgres_data.
После выгрузки сборки сервисы обновляются вручную. Мы заходим на VPS по SSH и выполняем две команды:
docker-compose build
docker-compose up -d
build пересобирает образы, а up -d пересоздаёт те контейнеры, которые изменились. Пока деплоем всегда занимается один человек, такой способ достаточно прост и предсказуем.
Позже деплой изменился. Статья описывает состояние на момент этой части. Сейчас GitHub Actions сам делает всё без ручных команд: каждый сервис выгружается отдельным заданием, и после выгрузки перезапускается только он, командами
docker compose build <сервис>иdocker compose up -d --force-recreate <сервис>по SSH.
Итоги
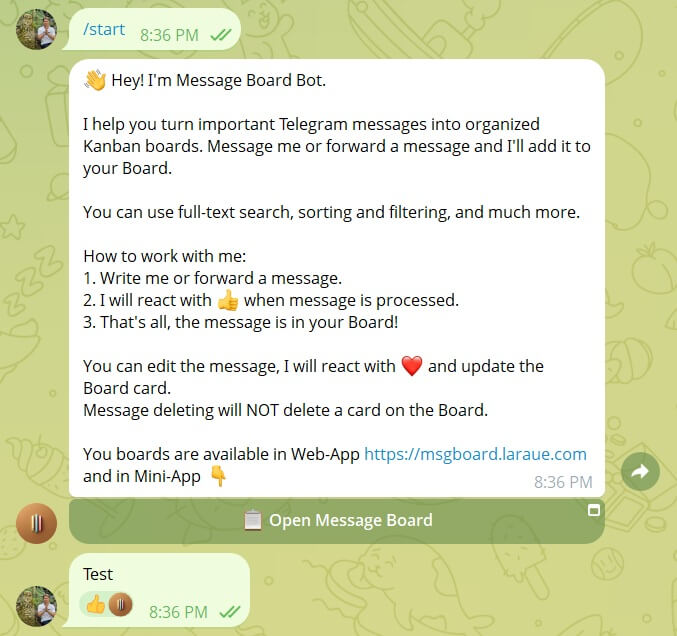
Бот выложен на дешёвый VPS: он работает в Docker, рядом запущена PostgreSQL, настроенная под 1 ГБ памяти и закрытая от публичного доступа. Сборка уходит на сервер через GitHub Actions при push в main. Бот работает с Telegram через long polling, вот как это выглядит:
Что дальше
Бот сохраняет задачи в базу, но управлять ими пока негде. Следующая статья — про фронтенд: как открыть его внутри Telegram в виде Mini App. Разберём настройку HTTPS в nginx с бесплатным сертификатом Let's Encrypt и задеплоим фронтенд.