Инструмент для парсинга сайтов на C# — идея, к которой я возвращался пять лет, причём с двух совершенно разных сторон. Начиналось всё как no-code SaaS: визуальный конструктор схем, аккаунты, кошелёк, доставка результатов по webhook. Закончилось Laraue.Crawling — строго типизированной open-source библиотекой для .NET. В статье — весь путь: идея, устройство первой версии вместе с тестами, места, где всё развалилось, и почему отказ от интерфейса в пользу библиотеки оказался верным решением.
Коротко о результате:
- no-code конструктор не нашёл своего пользователя: схемы собирали те, кто и без него умел писать селекторы;
- прокси и антибот-защита оказались отдельной задачей, которую внутри такого продукта не решить;
- библиотека, где схема описывается типизированным кодом на C#, а статический HTML, страницы на JavaScript и XML разбираются одинаково, оказалась в реальных проектах гораздо полезнее.
Идея: парсинг сайтов без программирования
Идея появилась в начале карьеры. Заказчики раз за разом просили вытащить данные из легаси-систем или с публичных сайтов, и всё повторялось: разобраться в структуре страницы, написать код с селекторами, разложить данные по модели, настроить расписание, организовать выгрузку. И каждый раз с нуля.
Хотелось убрать этот шаблонный код целиком. Если пользователь может в интерфейсе показать, в каких HTML-блоках лежат нужные данные, код для их извлечения можно сгенерировать автоматически. Без программирования.
Чтобы проверить гипотезу, я собрал минимальный прототип: API, которое отдавало сырой HTML страницы, и JavaScript, который встраивался во фронтенд. Скрипт рисовал красный прямоугольник вокруг элемента под курсором, а клики выводил в консоль. На простых статических сайтах это работало, и этого хватило, чтобы взяться за полноценную версию.
Первое приложение: как оно работало
После многих итераций получился процесс из трёх шагов.
Шаг 1. Создать схему. Пользователь открывал адрес страницы в приложении, наводил курсор на элементы и кликал по тем, из которых нужны данные. Приложение запоминало CSS-селекторы и собирало из них ParsingSchemeInfo — описание того, что и как извлекать.
Шаг 2. Выбрать страницы. Когда схема готова, приложение в фоне загружало sitemap сайта. Страницы можно было выбирать по шаблону, например «все адреса вида /products/*», а не отмечать по одной.
Шаг 3. Запустить и забрать результат. Парсинг запускался вручную или по расписанию. Результат приходил как CSV, JSON или webhook на любой адрес.
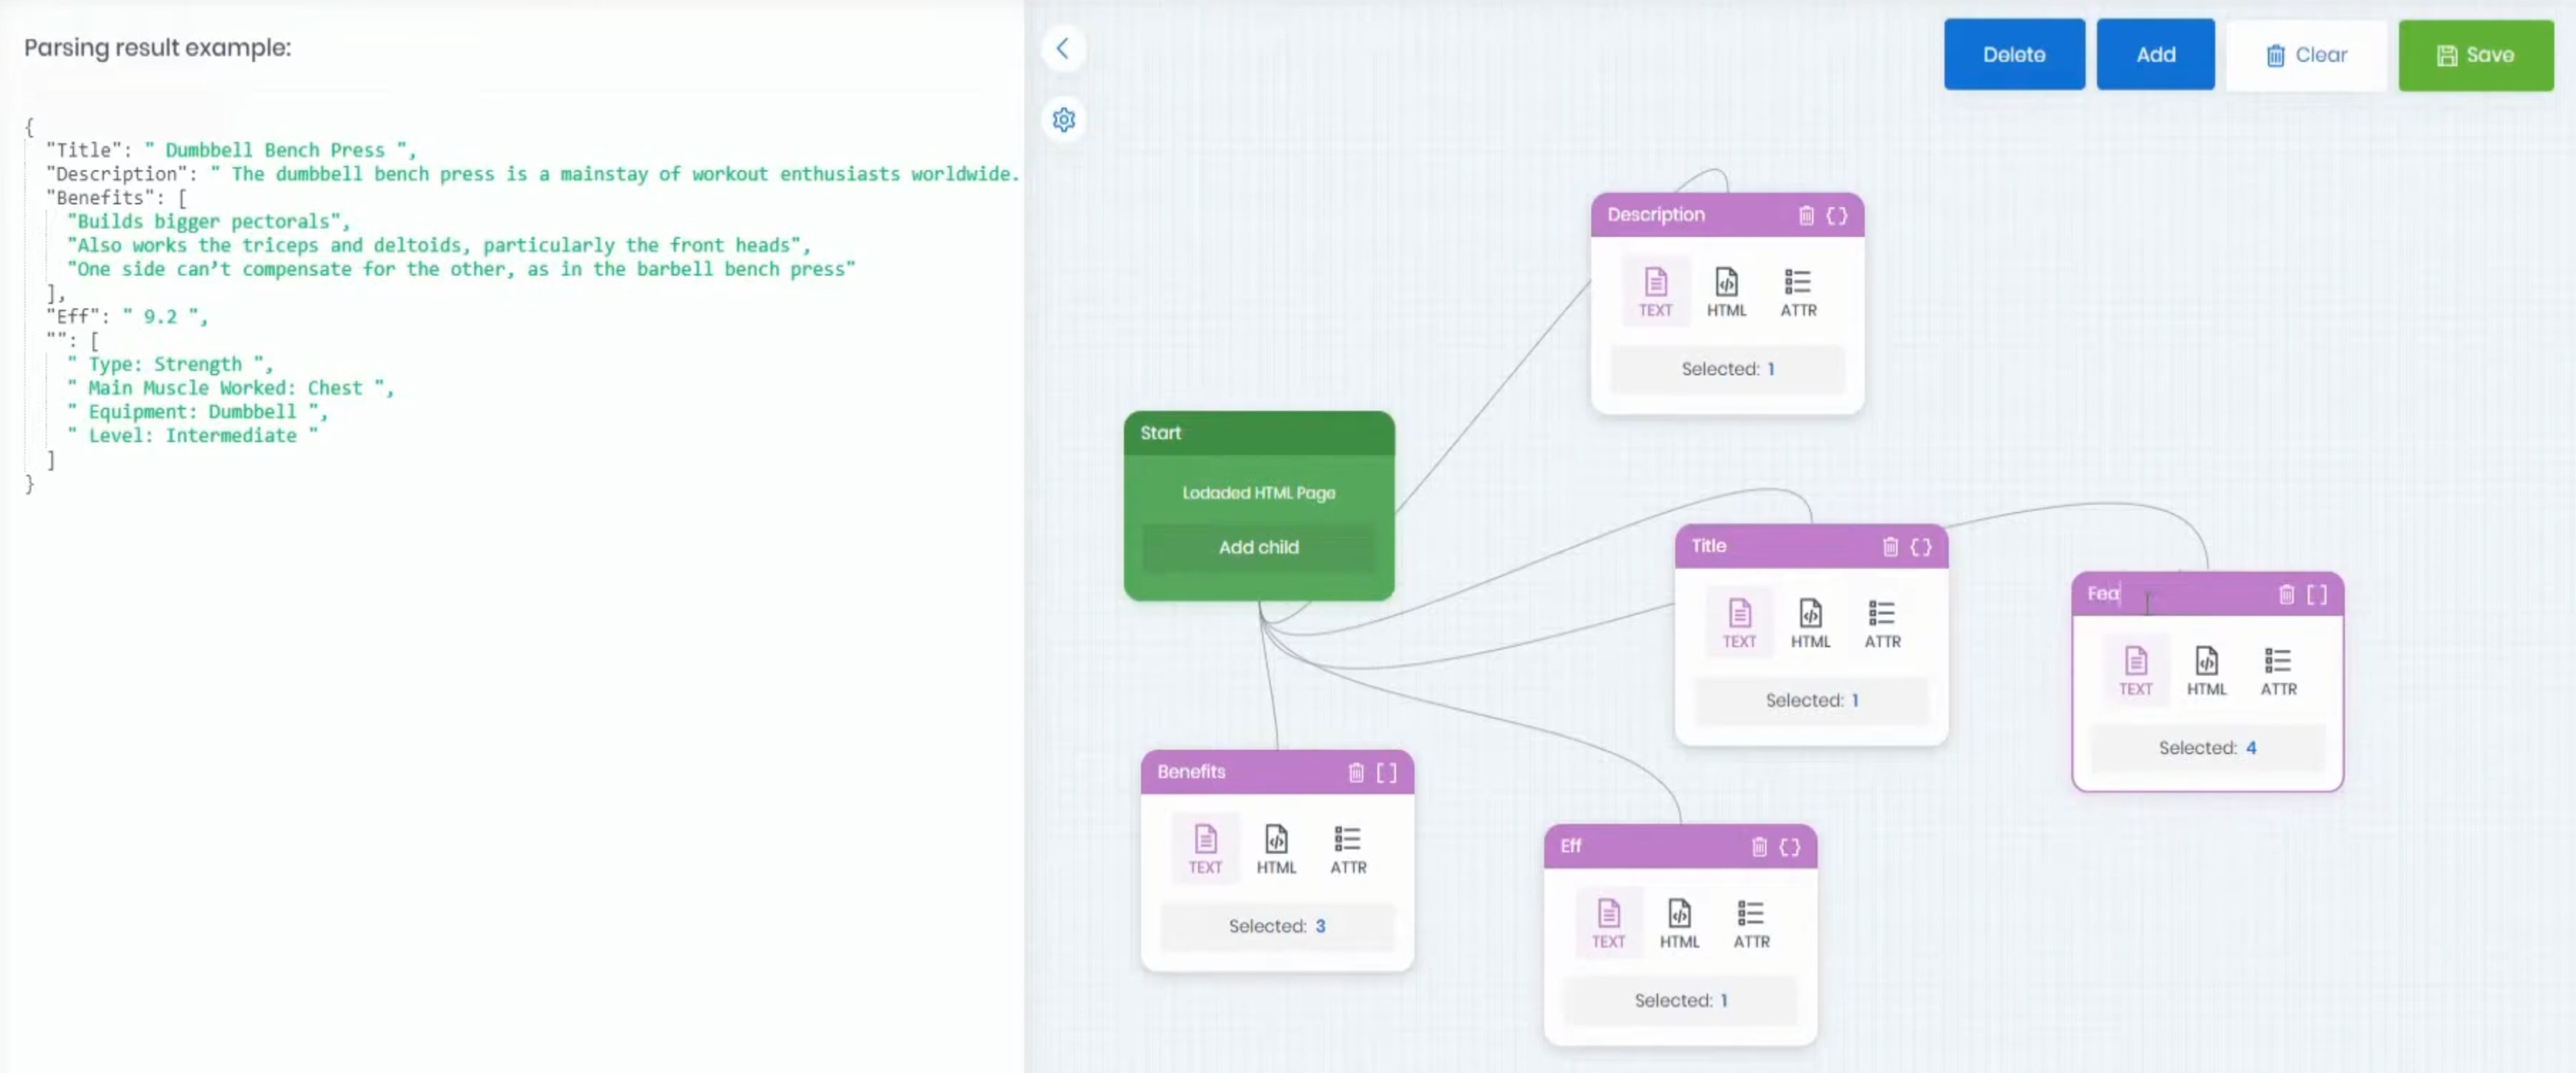
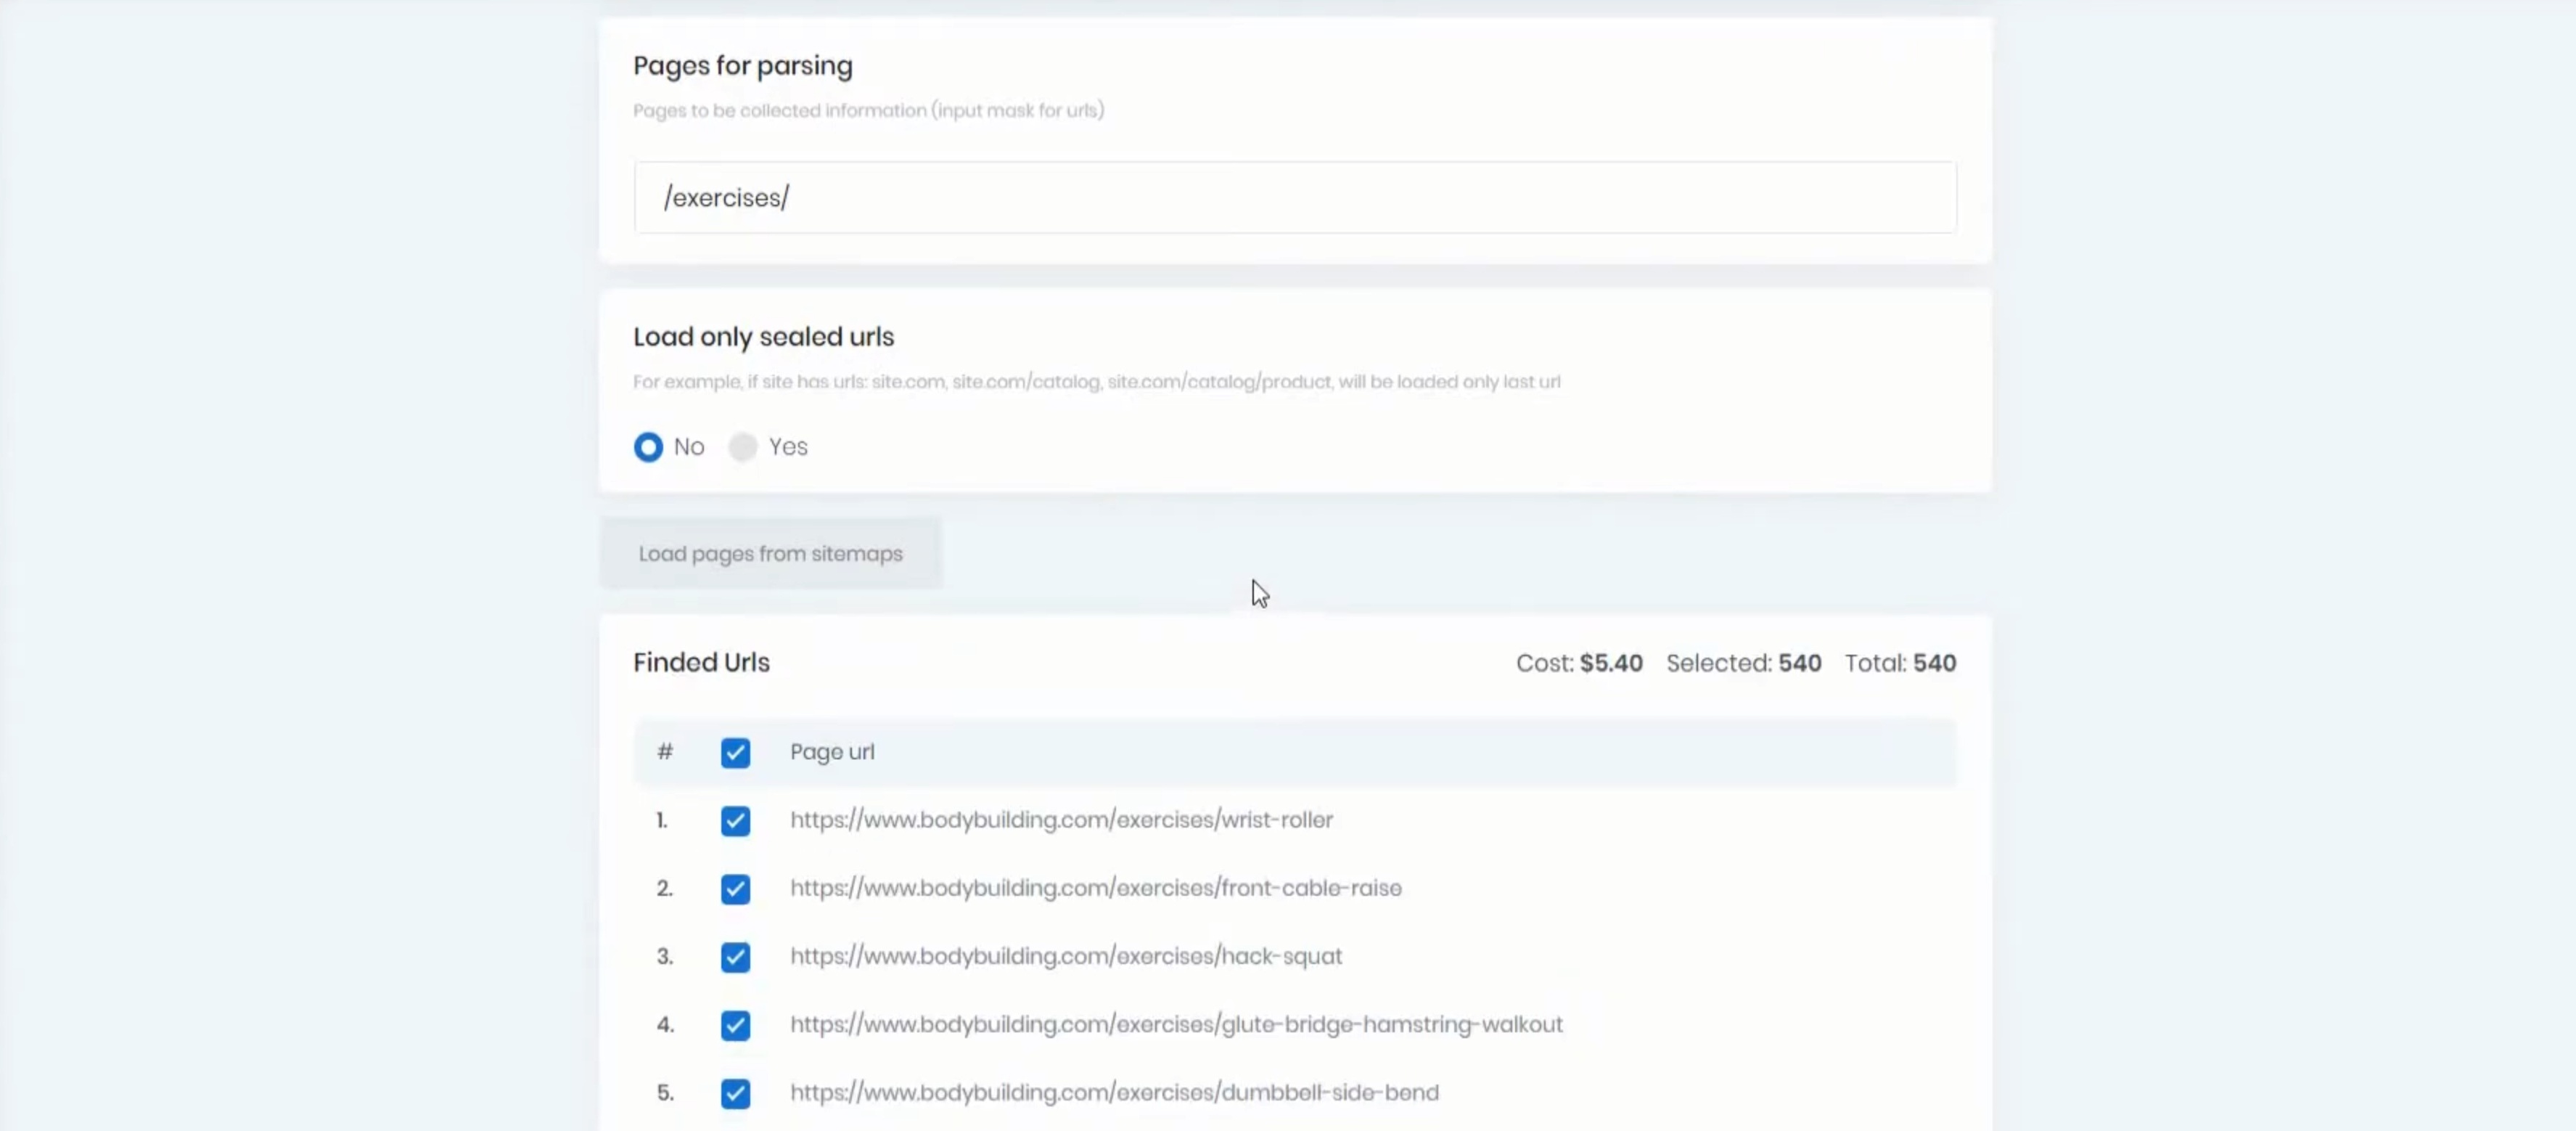
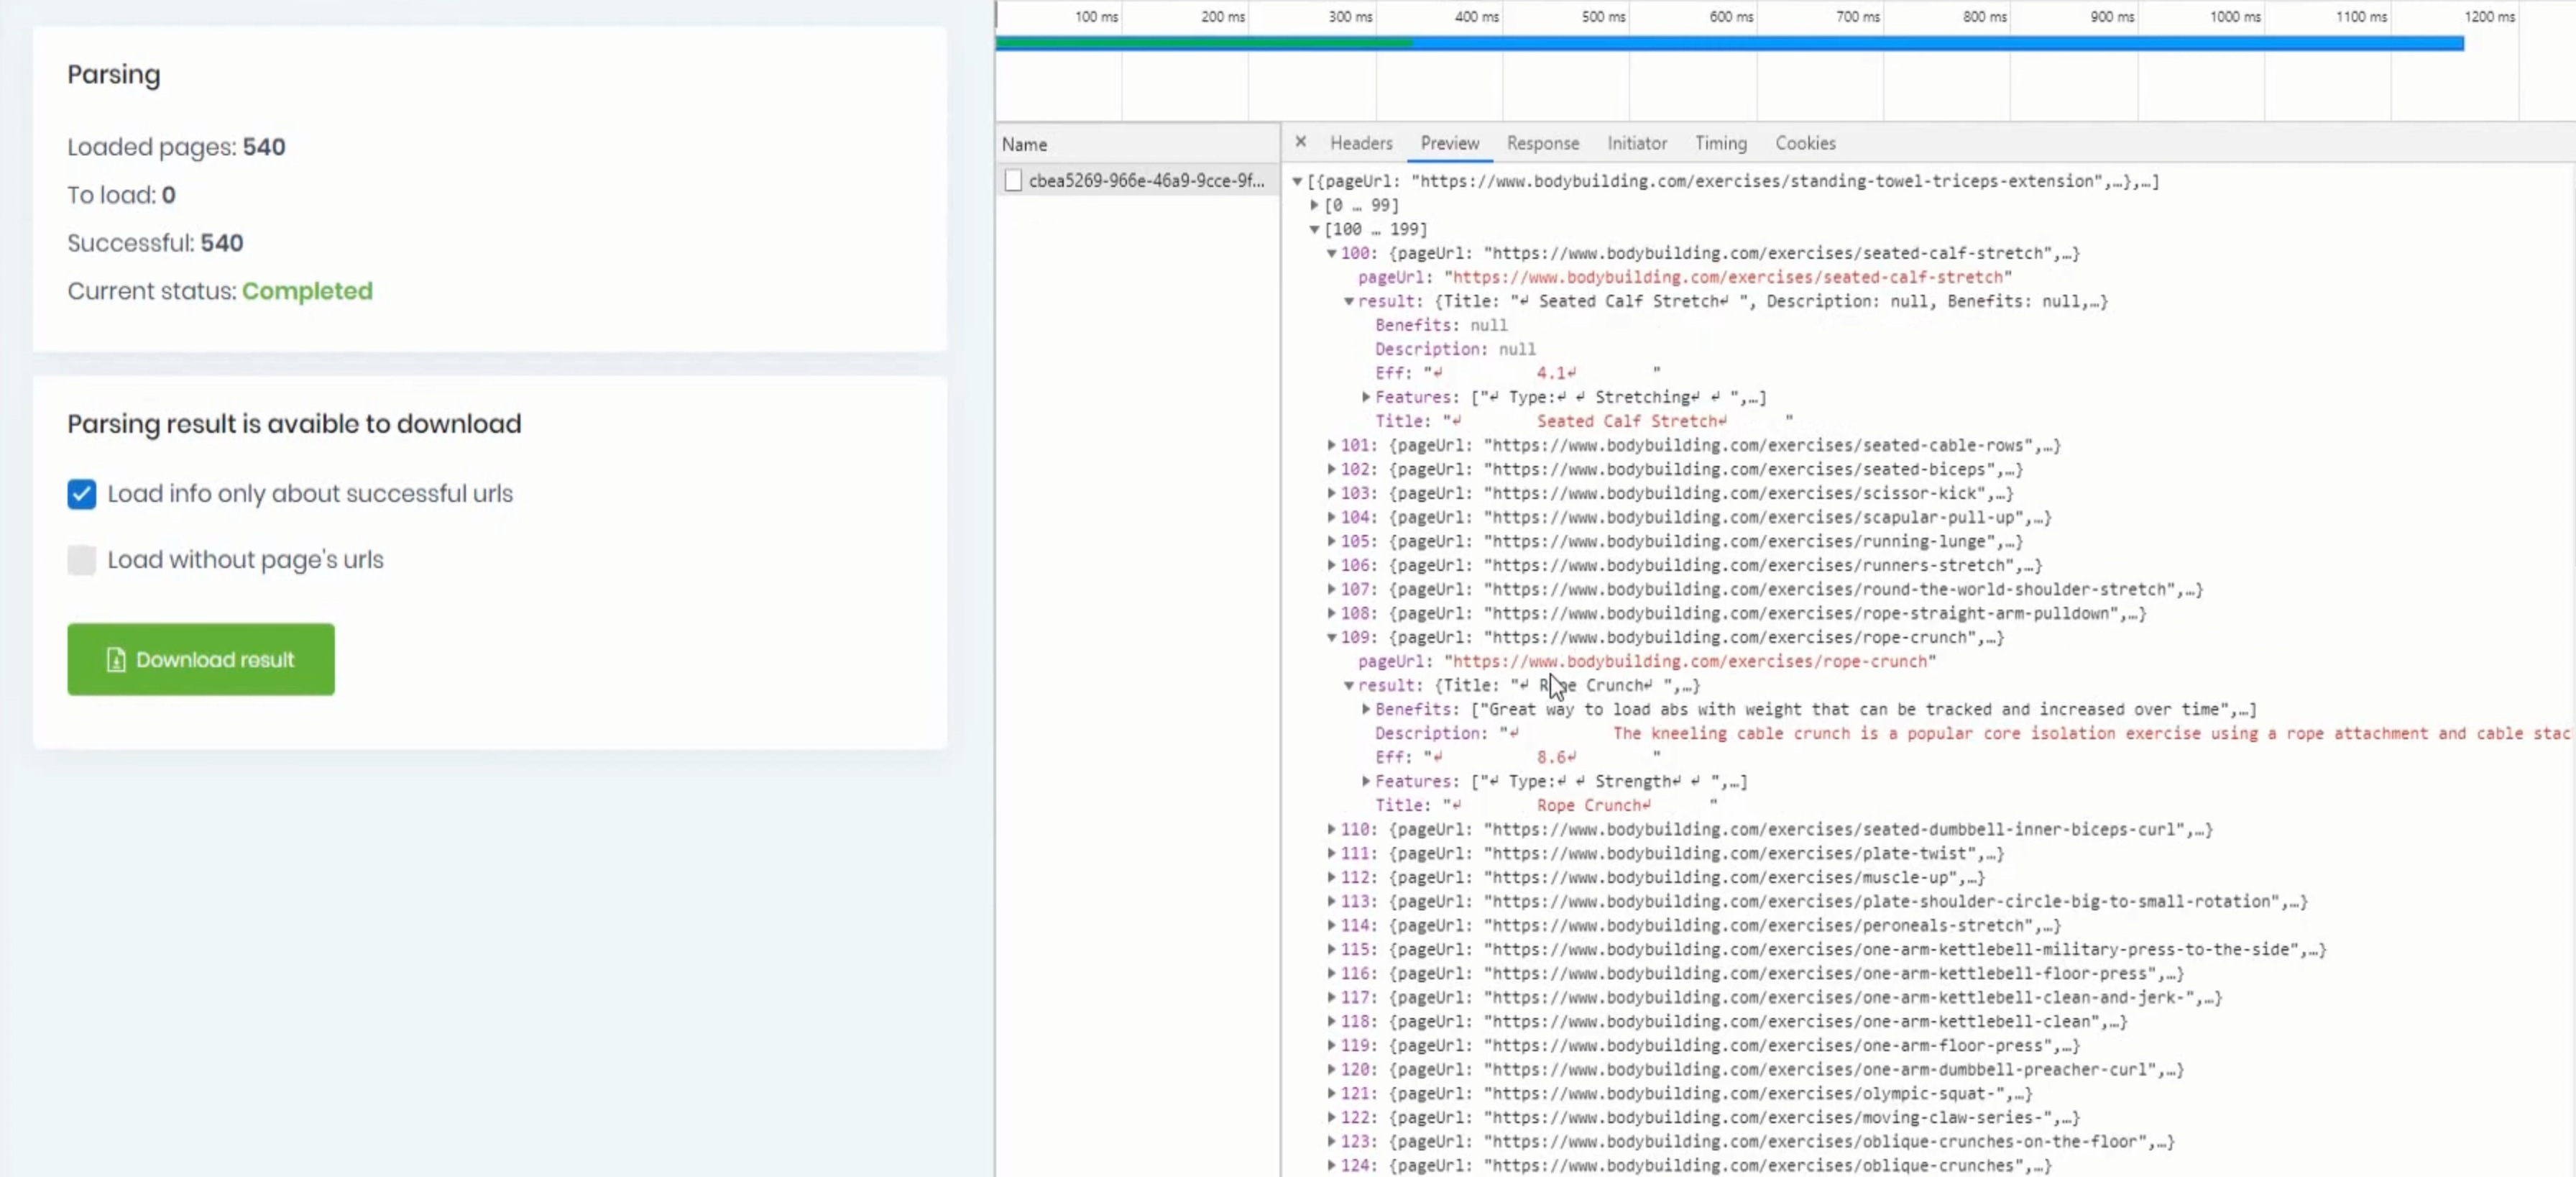
Как это выглядело в работе, показывает архивная запись:
Движок схем
Ядром приложения был движок схем. ParsingSchemeInfo хранил дерево блоков, и каждый блок описывал одно правило извлечения. Блоков было три типа.
ItemBlock достаёт значение или список значений по CSS-селектору. Флаг IsSingle решает, вернуть первое совпадение или все. Если задать Attribute, вместо текста будет взят атрибут элемента, например src или href.
ObjectBlock достаёт объект или массив объектов. Свойства каждого объекта описывают вложенные ItemBlock.
KeyBlock собирает вложенные блоки под одним именем в итоговом JSON и сам селектора не имеет.
Как блоки сочетаются, показывает ParsingSchemeTests из исходного репозитория (исходник):
// ItemBlock: текст из всех подходящих div
var scheme = new ParsingSchemeInfo
{
    Entities = new[] { new ItemBlock { Name = "F1", HtmlSelector = "div", IsSingle = false } }
};
var result = await scheme.ParseDataAsync("<div>12</div><div>13</div>");
// result["F1"] → JArray [12, 13]

// ItemBlock: атрибут вместо текста
var scheme = new ParsingSchemeInfo
{
    Entities = new[] { new ItemBlock { Name = "Image", HtmlSelector = "img", IsSingle = true, Attribute = "src" } }
};
var result = await scheme.ParseDataAsync("<img src=\"test\" />");
// result["Image"] → "test"

// ObjectBlock: строки таблицы как объекты
var scheme = new ParsingSchemeInfo
{
    Entities = new[]
    {
        new ObjectBlock
        {
            Name = "Value", HtmlSelector = "tr td", IsSingle = false,
            Entities = new ItemBlock[]
            {
                new() { Name = "H1", HtmlSelector = "h1", IsSingle = true },
                new() { Name = "H2", HtmlSelector = "h2", IsSingle = true },
            }
        }
    }
};
// result["Value"] → [{ H1: "Record1_h1", H2: "Record1_h2" }, { H1: "Record2_h1", H2: "Record2_h2" }]
Кроме того, у схемы было четыре режима ParsingMode, которые определяют, что именно берётся из найденного элемента:
| Режим | Что возвращает |
|---|---|
InnerText |
Только текст, без тегов |
InnerHtml |
HTML внутри элемента |
OuterHtml |
Сам элемент вместе с тегом |
InnerTextInOriginalTag |
Текст, обёрнутый в исходный тег элемента |
Последний режим пригождался, когда собранный текст вставляли на другой сайт и нужно было сохранить смысловую разметку.
Кошелёк: кредиты за парсинг
Приложение задумывалось как SaaS, поэтому каждая задача парсинга списывала кредиты с кошелька. Баланс состоял из двух частей: реального и бонусного (промо-кредиты). Бонусы тратились первыми, и реальные деньги списывались только после того, как бонусы заканчивались.
WalletTests (исходник) показывают схему транзакций «резерв — подтверждение — откат». В каждом тесте у пользователя на счёте 100 реальных кредитов и 0,30 бонусных:
// Перед запуском задачи резервируем сумму
using var reservedTransaction = await _mediator.Send(
    new ReserveBalanceCommand(userId, transactionId, TransactionReason.ParsingWithdrawal, 30M));

// Задача выполнена — подтверждаем, баланс уменьшается окончательно
var balanceChange = await reservedTransaction.CommitAsync();
// balanceChange.Difference → -29.7M (реальный), balanceChange.BonusDifference → -0.3M (бонусы ушли первыми)

// Задача провалилась — Dispose() откатывает резерв, баланс возвращается
reservedTransaction.Dispose(); // идемпотентен: второй вызов безопасен
Резерв блокирует сумму, чтобы пользователь не потратил её в другом месте, пока задача выполняется. Подтверждение записывает постоянную транзакцию. Откат через Dispose идемпотентен: двойной вызов проверяется отдельным тестом.
Отдельно проверялась конкурентность. Тест отправлял сто одновременных резервов на разные суммы и после подтверждения всех транзакций сверял итоговый баланс:
var reservedTransactions = await Task.WhenAll(
    Enumerable.Range(1, 100)
        .Select(i => _mediator.Send(new ReserveBalanceCommand(
            userId, transactionId, TransactionReason.ParsingWithdrawal, 0.01M * i))));

await Task.WhenAll(reservedTransactions.Select(x => x.CommitAsync()));

var balance = await _mediator.Send(new GetBalanceCommand(userId));
Assert.Equal(49.8M, balance.Total); // 100 + 0.30 бонусов − 50.50 (сумма 0.01…1.00) = 49.80
Всё это работало на MediatR, а об изменении баланса браузер узнавал по WebSocket. В тестах эти вызовы фиксировал мок IUserWebSocketHandler.
Где всё сломалось
Проблема 1. Рендеринг JavaScript
Конструктор схем встраивал JavaScript в страницу, открытую в iframe внутри фронтенда приложения. На статическом HTML это работало. Но многие сайты подгружают содержимое динамически: скрипт срабатывал раньше, чем контент появлялся, и кликать было не по чему.
Выходом стало разделение на две версии: веб-версия для статических страниц и десктопная, с настоящим браузером, для страниц на JavaScript. Стало только хуже: наткнувшись на динамическую страницу, пользователь был вынужден переходить в другой инструмент.
Проблема 2. Антибот-защита и прокси
Сайты, которые блокируют краулеры, оказались задачей посложнее. Облачные прокси-сервисы существовали, но стоили денег, а без выручки платить за них было нечем. Я написал несколько ротаторов прокси, но по-настоящему проверить, что конкретный прокси работает и запрос через него прошёл, было трудно. Одни прокси выглядели рабочими, но возвращали закэшированные или подменённые ответы. Другие молча теряли запросы. Как решить это надёжно в рамках ресурсов проекта, я не знал.
Проблема 3. Инструмент всё равно был для разработчиков
Когда конструктор схем и вся SaaS-обвязка были готовы, я посмотрел, кто на самом деле пользуется приложением. Пользу получали те, кто и так разбирался в селекторах, то есть, по сути, разработчики. Людям без технического опыта CSS-селекторы оставались непонятны даже с визуальной подсказкой. А технические пользователи со сложными задачами не хотели отдавать кому-то управление ротацией прокси и поведением браузера.
Приложение решало задачу человека, которого почти не существовало.
Переосмысление: библиотека вместо приложения
После перерыва картина прояснилась. Мне самому для других пет-проектов нужен был надёжный C#-инструмент, который достаёт структурированные данные и из статических страниц, и из страниц на JavaScript, чтобы не писать каждый раз один и тот же шаблонный код.
Новая идея: отказаться от интерфейса совсем и написать библиотеку на C#. Пусть разработчики сами решают, как менять прокси, запускать по расписанию и доставлять результат. Задача библиотеки — описывать схемы и выполнять их.
Первоначальный набросок API выглядел так:
var schema = new StaticCrawlingSchema() // или DynamicCrawlingSchema для JS-страниц
    .HasProperty("title", Types.String, ".title")
    .HasObjectProperty("user", ".user", userBuilder =>
    {
        userBuilder.HasProperty("name", Types.String, ".name")
            .HasProperty("age", Types.Int, ".age")
            .HasArrayProperty("dogs", ".dog", dogsBuilder =>
            {
                dogsBuilder.HasProperty("age", Types.Int, ".age")
                    .HasProperty("name", Types.String, ".name");
            });
    })
Типы везде: целые числа разбираются как Int32, даты — как DateTime, а функции преобразования справляются с крайними случаями. Перейти со статической схемы на динамическую должно быть можно с минимумом правок или вовсе без них.
Библиотека: две реализации
Первая реализация
В первой версии были отдельные типы StaticCrawlingSchema и DynamicCrawlingSchema на основе AngleSharp и PuppeteerSharp. Но схемы двух типов были почти несовместимы. Часто сайт, который казался статическим, на деле требовал JavaScript, и тогда схемы приходилось серьёзно переписывать.
Вторая реализация: единый билдер
Решением стал общий базовый класс билдера, параметризованный типом элемента:
public class DocumentSchemaBuilder<TElement, TModel>
    where TModel : class, ICrawlingModel
{
}
От него наследуются AngleSharpSchemaBuilder<TModel> и PuppeterSharpSchemaBuilder<TModel>. Оба используют один адаптерный интерфейс:
interface ICrawlingAdapter<in TNode>
{
    TDestination? MapValue<TDestination>(string? element);
    Task<object?> GetValueAsync(TNode? element, Type destinationType);
    Task<string?> GetInnerTextAsync(TNode? element);
    Task<string?> GetAttributeTextAsync(TNode? element, string attributeName);
}
Теперь, чтобы перейти с AngleSharpSchemaBuilder на PuppeterSharpSchemaBuilder, достаточно поменять имя класса билдера. Привязки свойств, вложенность объектов и функции преобразования остаются прежними.
Поддержка XML
Одному из проектов понадобилось разбирать XML, и пришлось сделать ещё одно обобщение: тип селектора стал параметром:
public class DocumentSchemaBuilder<TElement, TSelector, TModel>
    where TSelector : Selector
    where TModel : class, ICrawlingModel
{
}
Так CSS-селекторы для HTML и XPath удалось разделить, не дублируя логику схем. Один и тот же билдер работает для RSS-лент, sitemap и XML-ответов API.
Как это выглядит сейчас
В нынешней библиотеке схема описывается моделью и билдером. Вместо строковых имён свойств теперь выражения, так что опечатка в имени не пройдёт компиляцию:
public record ProductPage(string Title, string Price) : ICrawlingModel;

var schema = new AngleSharpSchemaBuilder<ProductPage>()
    .HasProperty(x => x.Title, "h1.title")
    .HasProperty(x => x.Price, ".price")
    .Build();
Полное описание API — на странице проекта.
Библиотека сегодня
Laraue.Crawling — открытая библиотека, и мы продолжаем её поддерживать. На ней работал краулер приложения по недвижимости, которое собрало больше 100 000 объявлений с Авито и Циана. Мы время от времени запускали его на локальной машине, сейчас не запускаем. Как в нём используются схема и приём раннего завершения, разобрано в статье об этой системе.
Библиотека распространяется под MIT, поддерживает современные версии .NET и доступна на NuGet:
dotnet add package Laraue.Crawling.Static.AngleSharp      # статический HTML
dotnet add package Laraue.Crawling.Dynamic.PuppeterSharp  # JavaScript-страницы
dotnet add package Laraue.Crawling.Static.Xml              # XML
Исходный код: github.com/win7user10/Laraue.Crawling
Выводы
Прежде чем строить инфраструктуру, выясните, кто на самом деле ваш пользователь. Кошелёк, webhook, расписание и ротация прокси — это серьёзная инженерная работа, а сделана она была для пользователя, который на деле оказался разработчиком и предпочёл бы API.
Простота интерфейса и мощность инструмента — прямой компромисс. Чтобы парсингом могли пользоваться люди без технической подготовки, пришлось бы спрятать понятия, на которых держатся краулеры. А без них инструмент перестаёт справляться с настоящими сайтами.
Прокси и антибот-защита заслуживают отдельного продукта. Надёжная ротация прокси — тяжёлая работа, которую нужно вести постоянно. Встраивать её с самого начала в инструмент для описания схем значило раздувать задачу.
Библиотека без интерфейса нужна реальному пользователю. Разработчик подключает её к тем планировщику, прокси, доставке и мониторингу, какие ему удобны, и ему не приходится бороться с чужими решениями в интерфейсе.